2019년 9월 6일 금요일

초서 독서법 김병완님의 책 독서 후기입니다.

올해부터는 독서를 하면 일부를 필사를 하고 블로그에 글을 남기면서 인상 깊었던 부분에 대해 글을 남기고 제 생각도 붙이고 있습니다. 읽기와 쓰기가 병행이 되면 상당한 임펙트를 남긴다고 들었는데 9개월정도 해보면서 꽤 효과를 거두고 있습니다. 올해 50권을 읽는 것이 목표였는데 60권을 돌파하고 있고 가능하면 독서 후기를 블로그에 남기고 있습니다.
초서 독서법 = 읽기 + 생각하기 + 쓰기 + 창조하기
일이 바쁜주간이면 한권도 읽지 못하는 경우도 많지만 집에 TV가 없다보니 아무래 바빠도 주말에 책 한권정도는 읽을 여유는 있습니다. 책을 계속 읽다보니 얇은 책은 한 3시간정도만 집중해도 그 자리에서 읽을 수 있습니다. 아무래도 직업이 강사이다 보니 책을 보는 습관이 꾸준히 발전한 것 같습니다. 이전에는 읽기만 했는데 요즘은 읽고나면 요약해서 정리하는 것이 오래 기억이 남는 방법임을 알게 되었습니다. 일종의 직업병처럼 습관이 만들어 진 것 같습니다.
C#, VB.NET, python, Objective-C, Swift와 같은 프로그래밍 언어를 강의로 만드는 경우도 비슷합니다. 처음에는 3권에서 5권 정도의 책을 보고 강의를 만듭니다. 몇개의 워드파일로 학습한 내용을 정리해서 강의에 활용합니다. 시간이 지나면서 한 분야에서 20권에서 30권정도 독서를 하고 실습을 하고 요약을 하다보면 좀 더 그 분야에 대해서 깊이있게 알게 되는 것 같습니다. 한 분야에 대해서 100권에서 1000권까지 독서를 한다면 그 분야의 전문가가 될 수 있습니다. 
이 책을 보면서 제가 경험적으로 알고 있던 부분이 너무나 체계적으로 정리가 되어 있어서 놀라기도 했습니다. 책을 읽으면서 생각하고 쓰고 자기 생각을 붙이고 하는 작업이 독서보다 더 중요하다는 것을 다시 한번 깨닫게 됩니다. 김병완님이 쓴 책을 다 읽고 싶다는 생각이 들정도로 좋은 책이였습니다. ^^
인상 깊은 문구들을 필사해 봅니다.
신이 준 선물인 뇌를 깨우고 자극하고 훈련시켜주는 전뇌 독서법이다. 손을 움직여 계속 기록하게 함으로써 해마와 대뇌피질이 원활하게 서로 정보를 나누도록 돕는다. 후두엽, 전두엽, 측두엽, 두엉엽은 물론이고 전전두엽까지 확장하고 움직이게 한다.
이 지도를 보면 손과 손가락이 대뇌피질의 감각영역과 운동영역을 가장 넓게 차지하고 있음을 알 수 있다. 결론적으로 손과 손가락을 움직이면 뇌를 광범위하게 자극하고 활동하게 할 수 있는 것이다. 손을 많이 사용하는 악기를 배우면 머리가 좋아지는 이유가 바로 여기에 있다. 젓가락을 사용하는 한국, 일본, 중국 사람들이 세계에서 가장 지능지수가 높은 이유도 여기에 있다. ==> 타이핑을 하는 것도 손을 사용하는 작업에 포함되는 것 같습니다. 필사가 힘들면 타이핑을 하기도 합니다. 아무래도 자료를 디지털화해서 남기고 있습니다.
책을 읽으면 왜 뇌가 좋아지는지에 대한 뇌과학 책을 읽은 사람은 독서를 결코 소홀히 할 수 없게 된다. 운동이 건강뿐만 아니라 뇌 발달에도 필수적 요소라는 사실에 대한 책을 읽은 사람은 운동에 시간을 더 할애하게 된다.
독서의 기능은 이것이다. 어제보다 더 나은 자신을 만들어가고, 자신의 수준을 높이고, 자신의 세계를 확장하는 것이다. 독서를 하지 않으면 우리는 나와 다른 삶을 살아갔던 사람들, 나보다 훨씬 위대한 삶을 살았던 이들의 삶과 경험을 알 수 없다.
논어와 맹자를 비교해보자. 논어는 초서 독서법으로 맹자는 퀀텀 독서법으로 읽어야 제맛이다. 논어는 구구절절 마다 깊이 사유하고 고찰해야 하는 책이고, 맹자는 구절이 아닌 통으로 읽고 통으로 이해해야 하는 책이기 때문이다.
장기 기억으로 분류되는 조건은 뭘까?
첫째, 뇌는 반복되는 정보를 장기기억으로 저장한다.
둘째, 뇌는 감정이 담긴 것을 장기기억으로 저장한다.
셋째, 뇌는 이미 아는 지식이나 정보와 관련 있는 것을 장기기억으로 저장한다.
넷째, 뇌는 그 사람이나 그 사람의 삶과 관련한 정보와 지식을 장기기억으로 저장한다.
다섯째, 뇌는 손으로 쓰는 것을 장기 기억으로 저장한다.
"손은 바깥으로 드러난 또 하나의 두뇌"라고 칸트가 말했다. 손을 움직이면 뇌가 활성화된다. 그래서 손을 자주 쓰는 사람이 지능도 발달하는 것이다. 손을 사용하는 독서인 초서 독서법은 뇌 활성화 운동이기도 하다.
다빈치는 책을 읽으면서 노트에 기록했고, 그 후로 무엇을 하더라도 기록하는 행위를 멈추지 않았다. 그는 생각나는 대로 왼손으로 또는 오른손으로 자유롭게 썻고, 그 내용에서 아이디어를 얻었다.
뇌가 건강해지면 더 행복해지고, 더 현명해지고, 더 많은 일을 잘해낼 수 있고, 더 건강해지고, 더 부유해지고, 무엇보다 독서를 더 잘할 수 있다.
책을 읽을 때 그 내용은 단기적 기억으로 그칠 수도 있고, 장기적으로 오랫동안 저장될 수도 있다. 그 차이를 결정하는 것이 바로 망상활성계다. 눈으로만 하는 독서는 망상활성계를 어김없이 가동시킨다. 그래서 읽고 나면 머릿속에 남는 것이 하나도 없는 "밑 빠진 독에 물붓기"독서가 된다.
이런 시간 낭비를 막기 위해서는 망상활성계를 뛰어넘는 독서법이 필요하다. 그것이 바로 손으로 하는 독서와 뇌로 하는 독서다. 전자가 초서 독서법이고 후자가 퀀텀 독서법이다.
초서 독서법은 손을 사용한다. 손으로 책의 내용과 함께 자신의 생각과 판단도 기록한다. 그러면 뇌는 이 정보들이 매우 중요한 정보라고 판단해 망상활성계를 가동시키지 않는다.
책 한권을 읽었다면 기준은?
첫째, 독서는 디코딩이 아니라 씽킹이다.
둘째, 독서는 사고력을 향상시크는 것이다.
셋째, 독서는 독자와 저자와의 대화이며 상호작용이다.
넷째, 독서는 생각의 재료를 얻는 과정이다.
다섯째, 읽을 때마다 목표와 목적이 정확히 있어야 한다.
여섯째, 단어나 문장이 아닌 주제나 주장을 읽어야 한다.
일곱째, 읽었다면 반드시 자기만의 한 문장을 창조해야 한다.
여덟째, 책과 자신의 사람을 연결시키고, 적용해야 한다.
아홉째, 책을 읽기 전과 후를 비교했을 때 달라진 점이 있어야 한다.
뇌 건강을 위한 좋은 습관
  1. 모든 일에 감사하고 긍정하는 습관
  2. 걷고, 씹고, 웃고, 노래 부르고, 춤추는 습관: 인간에게 가장 기본인 걷기, 씹기를 비롯해 웃기, 노래부르기, 춤추기를 하면 세로토닌 신경이 자극을 받아 활성화된다.
  3. 조깅, 수영등과 같은 운동을 꾸준히 하는 습관
  4. 매일 뭔가 새로운 것을 배우고 공부하는 습관
  5. 좋아하는 일을 하는 습관
  6. 삶의 의미와 목적을 갖고 도전하는 습관
  7. 물을 자주 마시고, 적절한 영향을 취하는 습관
  8. 사랑하는 사람들과 함께 많은 시간을 보내는 습관
  9. 타인을 위해 기도와 명상을 하는 습관
  10. 재미있고 즐겁고 활력을 주는 것들을 하는 습관
초서노트 작성법
제목과 표지에서 알 수 있는 것은 무엇인가?
차례에서 알 수 있는 것은 무엇인가?
책의 주제와 내용을 예측해서 기록해보자.
책을 제대로 이해하기 위해 필요한 사전 지식이나 분야는 무엇인가?
현대식 초서 독서법, BTMS배워보기
1단계: Book단계 책을 읽고 핵심 내용과 중요 문장을 파악한다.
2단계: Think단계 자신의 주관, 생각, 견해를 책에 덧입힌다.
3단계: Mind단계 책을 통해 자신의 의식 변화를 성찰한다.
4단계: Summary단계 해당 독서를 요약하고 마무리한다.


걷는 사람 하정우 독서 후기입니다.

저도 가능하면 하루에 1만2천보를 걸으려고 합니다. 작년에 다이어트를 한 이후에 1년 평균을 내보니 약 1만3천보를 걸었습니다. 요요현상이 나타나지 않는 것을 보니 현미와 채식도 중요하지만 걷는 행위도 매우 중요한 것 같습니다. 몸무게 84키로에서 75키로까지 줄이고 1년동안 유지하고 있습니다.
작년 9월에 애플와치3를 구매해서 1년을 사용하고 있습니다. 애플와치에서 평균을 내보니 하루 평균 1만3천보 달성한 것을 확인할 수 있습니다. 운동을 해야겠다는 결심이 했다면 하정우가 핏빗을 사용한 것 처럼 저는 애플와치를 착용해서 측정을 해 보시길 권하고 싶습니다. 측정하고 기록해야 개선할 수 있습니다. ^^ 아래가 제가 달성한 걷기 통계 입니다.
목차는 다음과 같습니다.
1부 하루 3만보, 가끔은 10만보
2부 먹다 걷다 웃다
3부 사람, 걸으면서 방황하는 존재
마포에서 강남까지 편도로 하루 3만보를 걷는다는 것을 읽고 무척 놀랐습니다. 저도 많이 걷는다고 생각했는데 거의 3배를 걸어다니고 하와이를 가면 최소 4만보에서 10만보를 걸었다고 하니 사람의 한계에 대해 깊이 생각하게 됩니다. ㅎㅎ
눈에 띄는 문구들을 필사해 봅니다.
내 갈 길을 스스로 선택해서 걷는 것, 내 보폭을 알고 무리하지 않는 것, 내 숨으로 걷는 것, 걷기에서 잊지 말아야 할 것은 묘하게도 인생과 이토록 닮았다.
나는 촬영을 앞두고 "급다이어트"를 해야 하는 경우, 절대 먹지 말아야 할 금지식만 몇 개 정해놓고 평소처럼 먹고 계속 걷는다. 햄버거, 탄산음료, 설탕과 소금이 과하게 들어간 음식 - 장담하는데 딱 이 메뉴만 식단에서 걷어내고 꾸준히 걷기만 해도 확실히 살이 빠진다. ==> 저는 맥주가 문제 입니다. ㅎㅎ 맥주와 과자만 줄여도 될 것 같습니다.
"도대체 누가 텔리비젼을 앉아서 봐?"
당연히 "제뛰"를 하며 보는 게 원칙이다. 이 역시 우리 걷기 모임 멤버들이 쓰는 용어로, "제자리뛰기"를 말한다. 우리의 구호는 또 있다. "비상구만이 살 길이다"
도저히 나가서 걸을 수 없을 것만 같은 날, 혹은 걷다가 체력이 달려서 집으로 당장 돌아가고 싶었던 날, 그런 순간들을 견디게 만든 것은 결국 걷기를 다 마치고 돌아올 때의 성취감이었다는 것을 기억해 낸다.
하와이에서 아직 해가 남아 있을 때 걸으면 노을이 내 머리 위로 가만히 흘러간다.
걷기의 매력 중 하나는 날씨와 계절의 변화를 피부로 느낄 수 있다는 점이다. 햇빛의 양이 적당해서 아주 아름답고 부드러운 매직 아워의 하늘 ==> 이 책의 단점은 다 읽고 나면 하와이를 가보고 싶다는 생각이 너무 많이 든다는 겁니다. ㅎㅎ
내가 지키는 루틴은 다음과 같다.
아침에 일어나자마자 일단 러닝머신 위에 올라가 걸으며 몸을 푼다.
아침식사는 반드시 챙겨먹는다.
작업실이나 영화사로 출근하는 길엔 별일이 없는 한 걷는다. ==> 저도 아침에 일어나면 무조건 스트레칭을 20분 합니다. 강의가 있어서 출근하는 날에는 삼성역에서 내려서 천천히 선릉역까지 걸어갑니다. 약 15분 정도 걸어서 도착하면 아침이 무척 상쾌합니다. 저녁에도 별일 없으면 커뮤니티에 있는 헬쓰장에서 걷고, 자전거를 타고 합니다. 루틴이 생기면 삶이 좀 더 단순해지고 건강해 집니다.
우리들만의 독서 모임에서 그간 읽은 책들의 리스트는 다음과 같다. 다비드 르 보르통의 "걷기 예찬", 구가야 아키라의 "최고의 휴식", 일자 샌트의 "센서티브", 마이클 해리스의 "잠시 혼자 있겠습니다.", 토니 포터의 "맨박스", 조훈현의 "조훈현, 고수의 생각법", 다다 후미아키의 "말의 한수", 이기주의 "말의 품격"등이다.
책을 보니 레오나르도 다빈치, 아인슈타인, 스필버그 등도 ADHD성향이 있었다고 한다.
그러나 한편으로 우리는 누구나 ADHD 성향을 갖고 있는지도 모른다는 생각도 들었다. 가만있기보다는 자꾸만 움직이고 싶고, 자신의 감정을 상대가 알아채지 못할까봐 넘치게 표현하고, 한 가지에만 진득하게 집중하지 못하는 성질, 이것은 가장 어린아이 다운 본능이기도 하다.
새로운 도시에 갔을 때 내 두 다리로 지도를 만들어나가는 이 작업은 내게 꽤 중요하다. "베를린"을 촬영할 때도 나는 일부러 숙소를 호텔이 아닌 브란덴부르크 광장 옆의 일반 주택으로 정해달라고 부탁했다. ==> 저도 여행을 가면 시내 중심지에서 걷기 좋은 것을 얻어서 많이 걸어다닙니다. 평균 하루에 3만보 정도는 걸었던 것 같습니다. 그래야 밤에 더 곤하게 잠을 잘 수 있습니다.
티베트어로 "인간"은 "걷는 존재" 혹은 "걸으면서 방황하는 존재"라는 의미라고 한다. 나는 기도한다. 내가 앞으로도 계속 걸어나가는 사람이기를. 어떤 상황에서도 한 발 더 내딘는 것을 포기하지 않는 사람이기를.
이 책을 다 읽고 나면 하와이로 날아가서 걸어보고 싶다는 생각이 많이 듭니다. 한번 도전해 보고 싶어졌습니다. 내 두 다리가 멀쩡하다면 끊임 없이 걷고 내 삶을 쇄신 했으면 좋겠습니다.


2019년 8월 23일 금요일

다시 산책하기 좋은 계절이 되었습니다. 주말에 1:30분정도 산책하고 왔습니다.

이제는 더위도 좀 덜하고 아침저녁으로 선선한 바람도 불고 하네요. 오랜만에 카메라들고 산책 다녀왔습니다. 보통 아침에 20분에서 1시간정도 산책을 합니다. 6살 몽실이 데리고 자주 산책을 다닙니다. 이제는 낮에만 좀 덥고 견딜만 합니다.
걷는 사람 하정우란 책을 읽다보니 하루에 3만보를 걷더군요. 저는 평균 1만2천보를 걷습니다. 1만5천보로 늘려보려고 합니다. 생활속에서 걸음수를 좀 더 올려보려고 합니다. 1년정도 사용한 애플와치가 운동에 많이 도움이 됩니다.


2019년 8월 21일 수요일

멀티캠퍼스에서 진행되었던 ML Studio 테크 밋업 야간 과외 후기입니다. ML Studio 정말 물건입니다. ^^

Azure ML Studio 밋업 세미나
데브옵스 코리아 대표 조철현
전미정 강사
앱 개발 Keras
인공지능 전문가만 하는 것은 아니다.
1부. 머신러닝 개론
2부. 핸즈옵 랩
기계를 인간과 비슷하게 동작하게 만드는 기술
인지 이해 반응
인공지능 -> 머신러닝 -> 딥러닝(머신러닝을 구헌하는 다양한 방법 중에 하나)
데이터가 있어야 머신러닝을 할 수 있다.
Machine Learning Bubble Chart
Supervised Learning(지도 학습, 감독학습)
문제와 정답 제공
-Feature & Label
예측, 추정, 분류
-Regression/Forecast/Classification
(쉽고 성능도 잘 나오는 편이다.)
시간에 따른 커피의 소비량(회귀)
Unsupervised Learning(비지도 학습)
문제만 제공
-Feature
패턴/구조 발견
그룹화
Anomaly Detection 비정상거래를 감지
Clustering
태깅을 하지 않고도 작업할 수 있다.
Reinforcement Learning(강화 학습)
보상 제공
인과관계가 중요
게임(알파고), 로봇
머신러닝 방법
방법이 엄청나게 많다. ML Studio에서 제공되는 것은 무엇인지 본다.
뉴럴 네트워크가 바로 딥러닝이다. 인간이 학습하는 뇌구조처럼 컴퓨터도 비슷하게 처리해 보자.
입력
입력 인공신경 출력
입력
층을 여러개 쌓아서 처리할 수 있다.
머신러닝 딥러닝
Input Input
Feature Engineering Feature Extraction
Traditional ML Neural Network
Output Output
(도메인에 대한
전문적인 지식이 필요하다.)
                (피처가 많다면... 피처의 추출을 기계가 한다. ) 
머신러닝의 헬로우월드 타이타닉 생존여부
Y = w*X + b
(라벨). (피처)
근무 연수 연봉
....
데이터에 점을 찍을 수 있다.
실제 값을 통해 데이터 값을 구할 수 있다.
w와 b를 머신러닝 모델이 구해줍니다.
X = Feature Y = Label
70~80%는 학습에
사용한다.
30%는 테스트에 사용
슈퍼바이저의 리그레션을 하게 됨
친절한 Azure ML Studio HOL
custom model 생성
전통적인 머신러닝 방법을 사용한다.
microsoft model 활용
Cognitive Service를 통해 미리 만들어진 것을 쓴다.
Azure Machine Learning Studio
Azure Machine Learning Service
하이퍼 파라메터들의 값
파이썬을 잘하고 싶은 것이 아닌 머신러닝을 하고 싶은데...
추가로 코드를 연결할 수 도 있다.
Best tool for ML Beginner
무료도 가능 10기가 까지 데이터 가능
문제 정의
데이터 셋 준비
모델 설정
모델 훈련 / 평가
모델 활용
총 111개 모듈
미국 45개 월 마트 부서별 주간 판매액 예측 모델
part1. 데이터 전처리
part2. 모델 학습 / 예측
part1. 데이터 전처리
데이터 지원 형식
원만한 데이터는 다 지원이 된다.
데이터 지원 유형
문자열
정수
double
BOOLEAN
Datetime
timespan
데이터 지원 용량
2기가
전체 10기가 정도(무료 버전)
kaggle에 올라왔던 문제임
feature.csv. train.csv. stores.csv
12열 8천개 5열 42만개. 3열 45개 지점
3개를 키를 통해 스튜디오에서 묶어서 사용한다.
키는 지점을 잡으면 된다. 그리고 날짜로 묶는다.
3개의 파일을 모두 업로드를 한다.
왼쪽의 데이터셋 아이콘을 클릭하고 From Local File이 나오면 3개의 파일을 모두 업로드하면 된다.
스크린샷 2019-08-21 오후 8.26.39.png
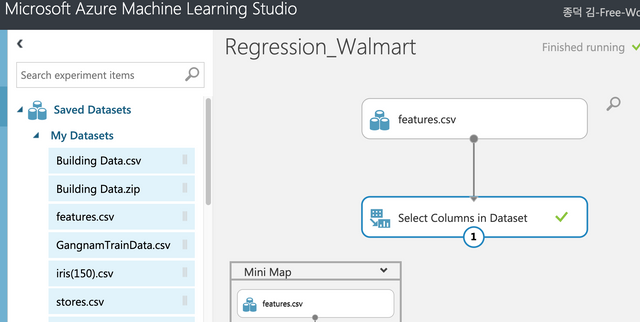
Saved Datasets에서 My Datasets를 클릭해서 업로드한 파일중에 features.csv파일을 드래그&드롭한다.
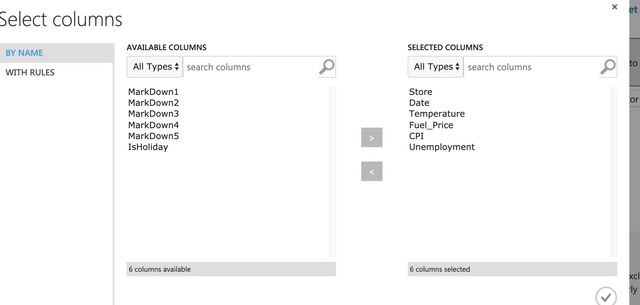
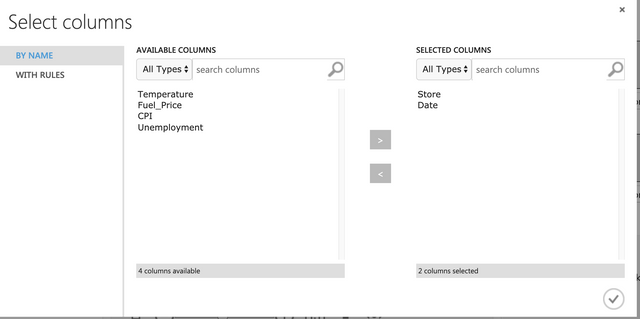
Features에서 6개의 컬럼만 선택한다. 마크다운, 홀리데이는 제외한다. Select Columns in Dataset에서 아래와 같이 선택하면 된다.
스크린샷 2019-08-21 오후 8.25.21.png
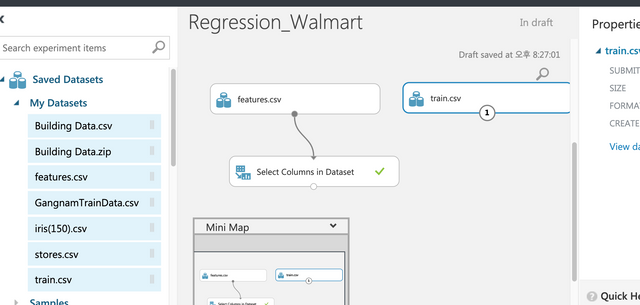
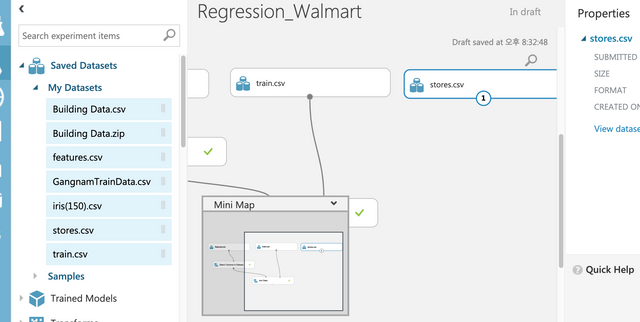
이번에는 업로드한 파일 중에 train.csv파일을 드래그&드롭한다. 데이터를 키컬럼을 사용해서 조인해야 한다.
스크린샷 2019-08-21 오후 8.27.09.png
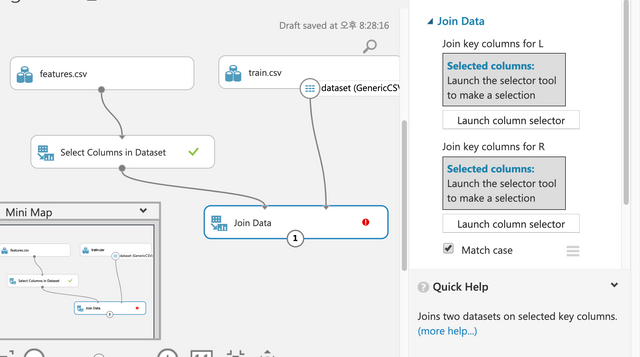
Join Data를 드래그&드롭하고 라인을 아래와 같이 연결한다.
스크린샷 2019-08-21 오후 8.28.29.png
Match Case의 경우 대소문자 구문 지금은 동일하다. 체크한 상태
Keep right key는 언체크해서 동일한 컬럼이 생기지 않게 한다. 양쪽 데이터셋에 같은 컬럼이 있기 때문에 중복이 발생하지 않도록 언체크해야 한다.
스크린샷 2019-08-21 오후 8.29.22.png
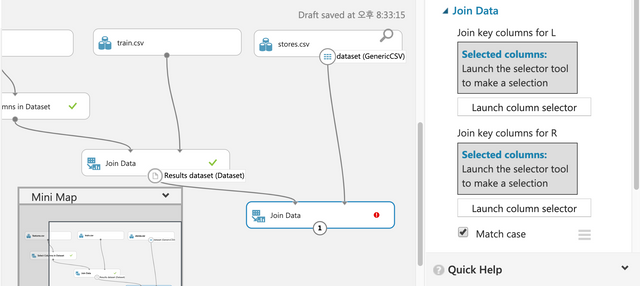
이번에는 stores.csv파일을 드래그&드롭하고 join data를 드래그&드롭해서 아래와 같이 연결한다.
스크린샷 2019-08-21 오후 8.32.57.png
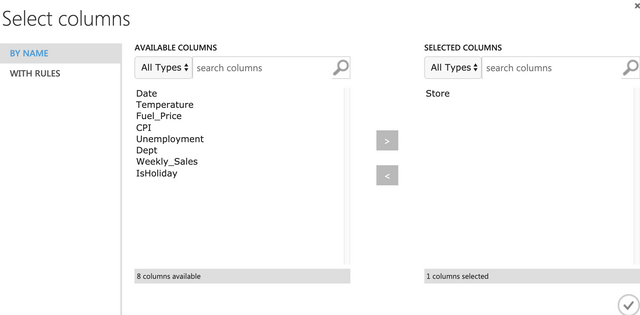
이번에는 Store만을 선택해서 키로 추가해서 조인을 처리하면 된다.
스크린샷 2019-08-21 오후 8.33.36.png
스크린샷 2019-08-21 오후 8.34.08.png
하단의 Run버튼을 클릭해서 실행결과를 한번 확인해 본다.
Edit Metadata를 사용해서 데이터를 전처리 한다.
스크린샷 2019-08-21 오후 8.36.39.png
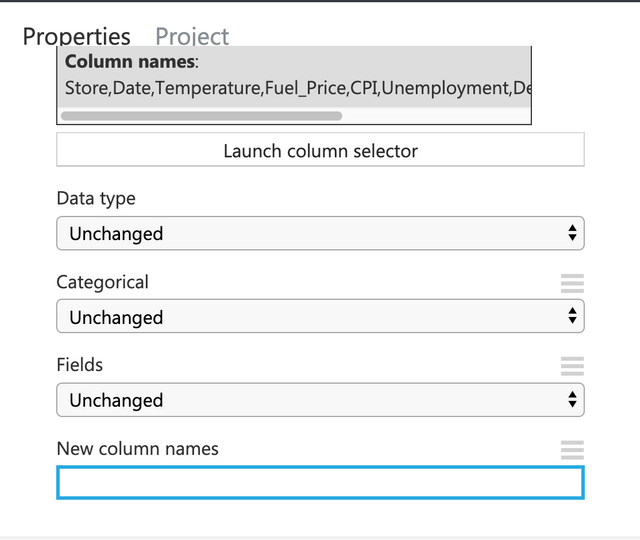
오른쪽 상단의 Launch column selector에서 11개의 컬럼을 모두 선택해서 오른쪽으로 배치한다.
스크린샷 2019-08-21 오후 8.37.15.png
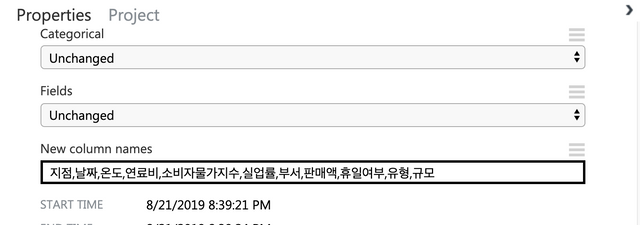
New column names에 아래와 같이 한글로 된 컬럼이름을 입력한다. 갯수가 11개인지 체크한다.
지점,날짜,온도,연료비,소비자물가지수,실업률,부서,판매액,휴일여부,유형,규모
스크린샷 2019-08-21 오후 8.39.53.png
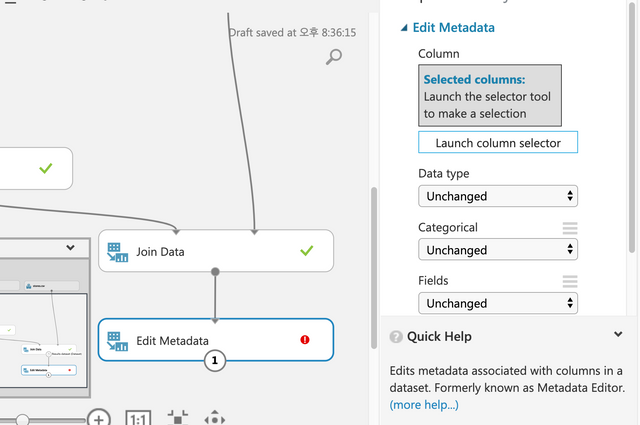
Edit Metadata를 하나 더 드래그&드롭한다. 위에서 아래로 라인을 연결한다. 추가된 Edit Metadata에서 Launch Select Column을 클릭한다.
스크린샷 2019-08-21 오후 8.41.34.png
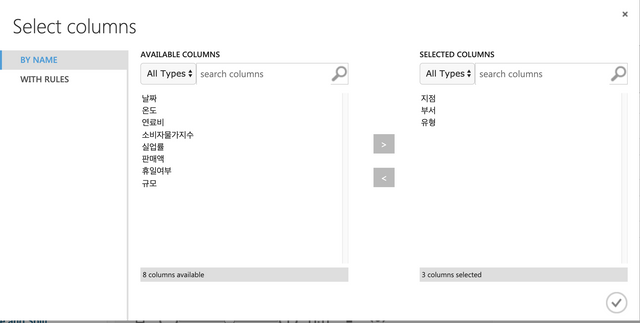
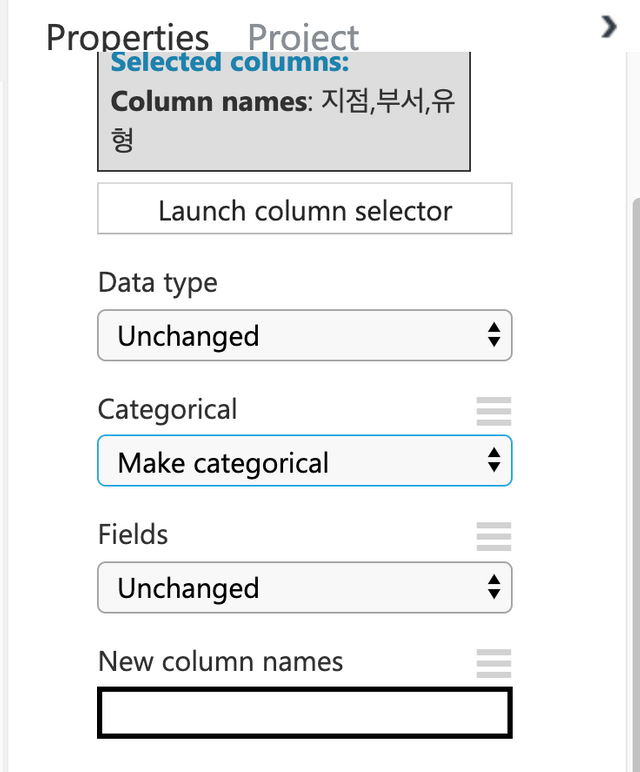
카테고리형태로 입력되는 3개의 피처들이 있다. 지점,부서,유형을 선택해서 카테고리형태로 변경해 주도록 한다.
스크린샷 2019-08-21 오후 8.42.06.png
오른쪽의 Properties에서 Categorical을 Make categorical로 변경한다.
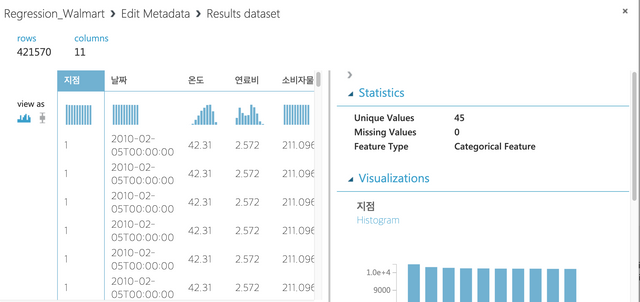
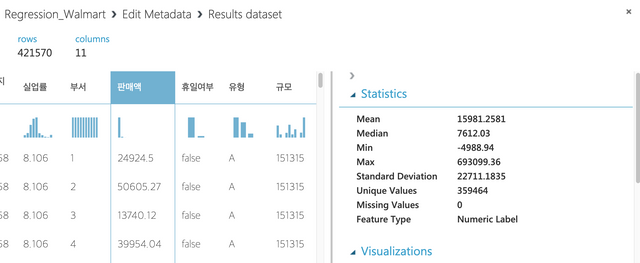
Run을 하고 결과를 보면 아래와 같이 Statistics에 Feature Type이 Categorical Feature로 변경되어 있다.
스크린샷 2019-08-21 오후 8.42.50.png
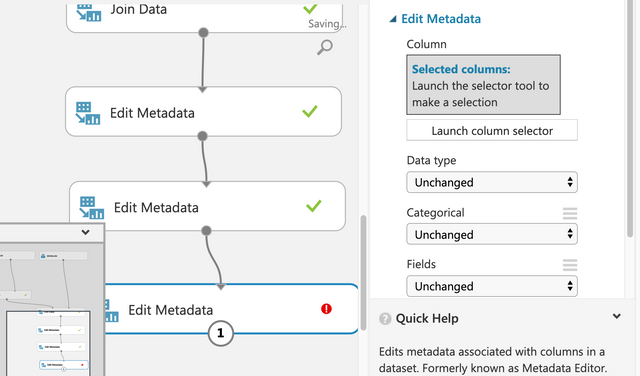
다시 Edit Metadata를 하나 더 추가한다. 아래와 같이 연결한다
스크린샷 2019-08-21 오후 8.44.18.png
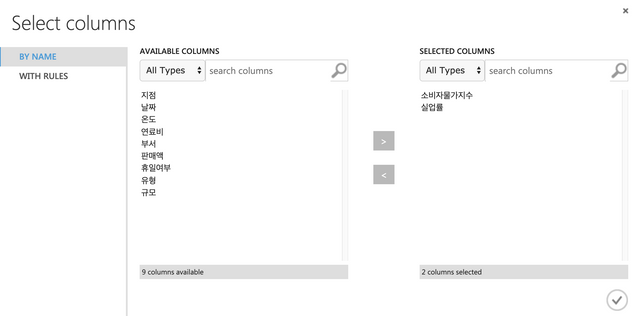
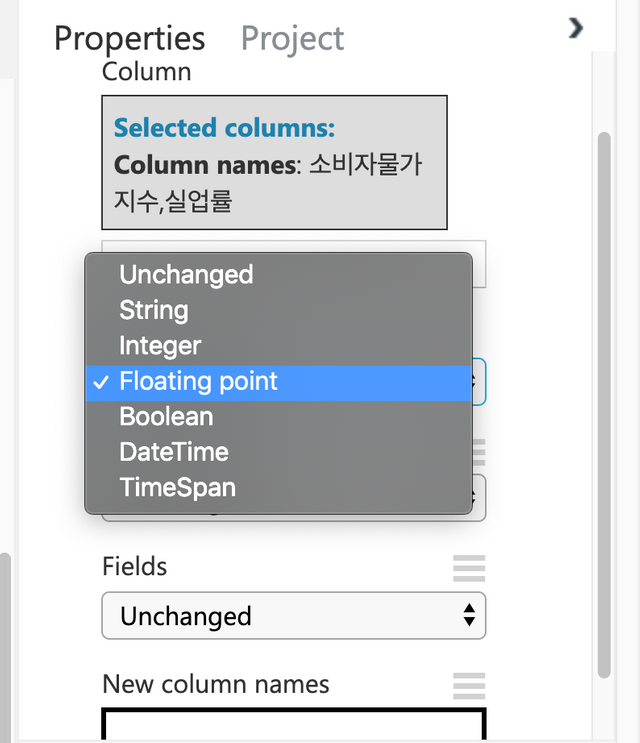
소비자물가지수와 실업률을 선택한다.
Feature가 String으로 되어 있는 것을 아래와 같이 Data Type에서 Floating point로 변경한다.
스크린샷 2019-08-21 오후 8.44.34.png
다시 하나 더 Edit Metadata를 추가한다.
스크린샷 2019-08-21 오후 8.44.59.png
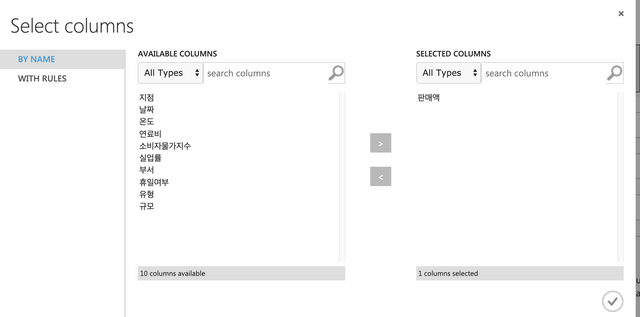
판매액을 선택한다.
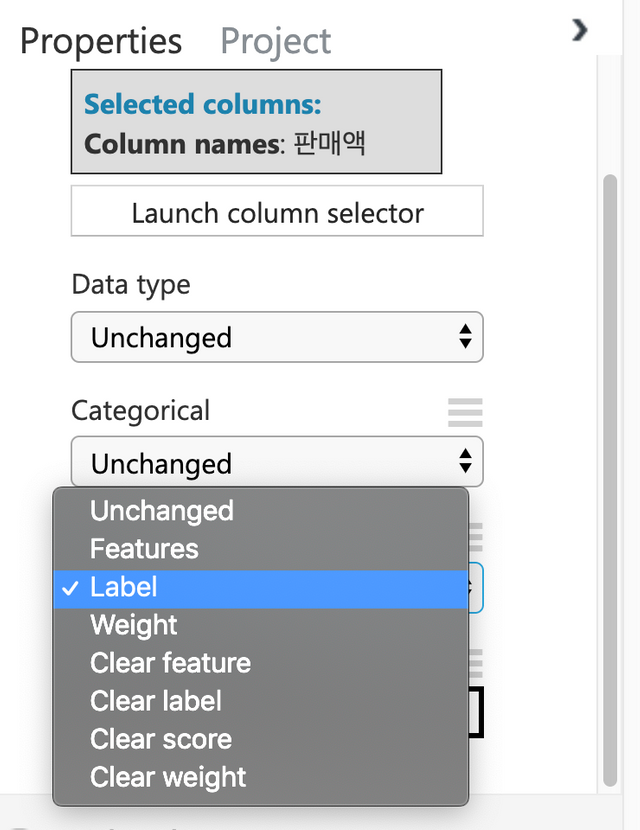
아래와 같이 Fields에서 Label로 변경한다.
스크린샷 2019-08-21 오후 8.48.05.png
스크린샷 2019-08-21 오후 8.48.24.png
스크린샷 2019-08-21 오후 8.49.01.png
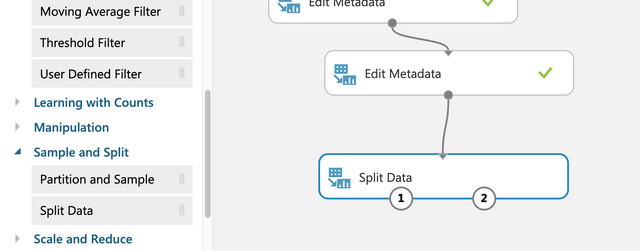
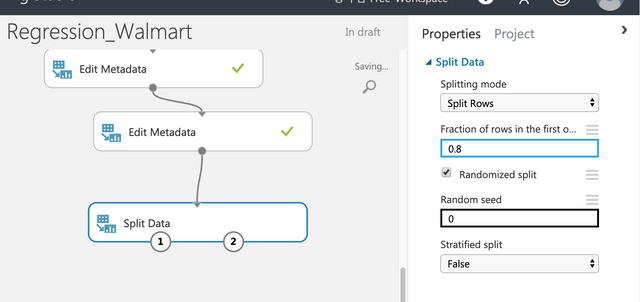
트레이닝과 테스트를 분리하기 위해 아래와 같이 Split Data를 연결한다. 0.8을 입력한다.
스크린샷 2019-08-21 오후 8.50.41.png
Random seed에는 0이 아는 좋아하는 아무 숫자나 입력하면 된다. 99를 입력한다. 앞에서부터 추출하는 것이 아는 랜덤하게 추출해서 훈련과 테스트가 정상적으로 진행될 수 있다.
스크린샷 2019-08-21 오후 8.51.41.png
Random Split
데이터가 순서대로 나열되어 있을 수 도 있기 때문에 랜덤하게 데이터를 뽑아와야 한다.
0.8을 입력해서 80프로 / 30프로로 나누어서 사용한다.
Random seed를 준다. 약간의 성능차이가 날 수 있다. 성능의 차이가 알고리즘인지? 랜덤해서 만든건지? 랜덤시드를 고정하면 이럼 고민을 덜 수 있다. 랜덤 선별 방식을 고정할 수 있다. 랜덤하게 뽑는 규칙은 고정하겠다는 것이 랜덤시드이다.
랜덤시드를 0으로 하면 사용하지 않겠다는 뜻. 원하는 숫자를 아무거나 입력한다.
Stratified Split
샘플링을 해야 한다.
데이터를 가지고 생각할 것이 엄청나게 많다.
케라스 코리아 You Only Look Keras
Initial Model 알고리즘 선택
Train Model 모델을 트레이닝
Score Model 평가하는 모델
Evaluate Model
Deploy Model
어떤 알고리즘을 써야하는가? 그때 그때 마다 다르다.
On size & quality of data
지도 학습 - Classification, Regression, Anomaly Detection
비지도 학습 - 클러스터링
Reinforcement - 아직 지원 안함
Accuracy(정확도를 얼마만큼 할 것 인가?)
정확도를 너무 높이면 오버피팅이 발생하고 시간이 많이 걸린다.
Parameter
Feature
ML Studio는 25개의 알고리즘을 제공한다.
치팅 시트를 제공한다.
Regression에서 8개의 알고리즘을 제공한다.
Ordinal Regression ; 데이터 내 상대적 순서나 랭킹 예측
Poisson Regression : 이떤 이벤트가 발생할 횟수 예측. 어떤 사람이 병원에 가게될 횟수
Fast Forest Quantile Regression: 값의 분산/분포 예측
Linear : 선형 알고리즘
Bayesian Linear Regression
Neural Network Regression
Decision Forest Regression: 오퍼피팅에 중의
Boosted Decision Tree Regression: 이전 트리에 종속되어 있어 메모리 사용이 큼. 정확도가 높음. 앙상블 모델에 활용
(아래의 5개를 사용하면 된다.)
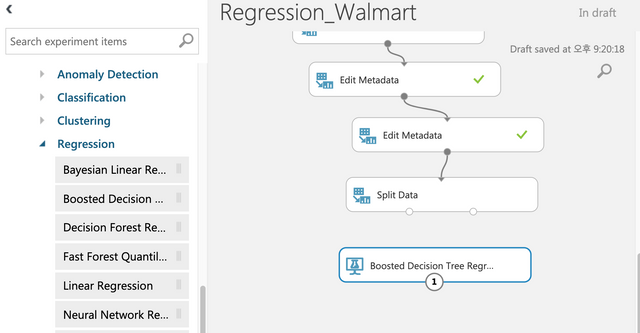
Boosted Decision Tree 를 알고리즘으로 사용한다.
스크린샷 2019-08-21 오후 9.31.54.png
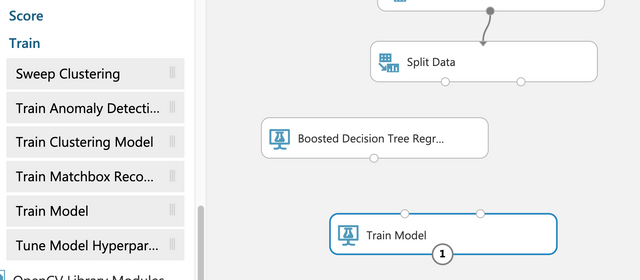
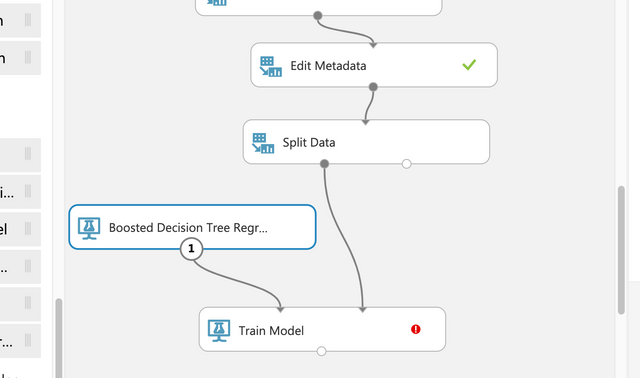
Boosted Decision Tree Regression과 Train Model을 연결하고 Split Data와 Train Model을 연결한다.
스크린샷 2019-08-21 오후 9.32.27.png
스크린샷 2019-08-21 오후 9.33.10.png
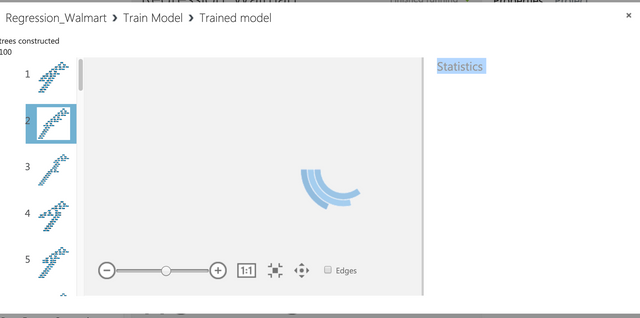
하단의 Run버튼을 클릭한다. 아래와 같은 Decision Tree가 나온 것을 볼 수 있다.
스크린샷 2019-08-21 오후 9.34.00.png
Score Model을 드래그&드롭하고 Train Model과 Score Model을 연결하고 Split Data에서 Score Model로 연결한다.
Evaluate Model을 드래그&드롭해서 아래와 같이 연결한다.
42만개의 데이터를 80프로는 모델, 20프로는 테스트로 사용한다.
판매액과 Scored Labels을 비교하면 잘 예측을 했는지를 알 수 있다. 우리가 예측한 모델이다.
Metrics가 5개로 나온다.
Mean Absolute Error 는 적은 값이 나오면 좋다.
p = predicted value 예측 값
a = actual value 실제 값
아래와 같이 시각화해서 결과를 확인할 수 있다.
스크린샷 2019-08-21 오후 9.37.06.png
Index Error. Error. Error^2
1 2 2 4
2 2 2 4
3 2 2 4
4 2 2 4
5 2 2 4
MAE(Mean Absolute Error)
MSE(Mean Square Error)
몇개의 튀는 데이터가 있다. 튀는 데이터를 중요하게 봐야 한다. 예측할 때 잘 맞추어야 한다.
골고루 맞추는 경우는 Mean Absolute Error를 사용한다.
모델이 잘 만들어진 것을 판단할 때 사용한다.
어떤 모델이 적합한지를 결정하기 힘들다. Evaluate Model의 상단에는 점이 2개가 있다. 동시에 2개를 연결할 수 있다.
All models are wrong
but some are useful
George Box
알고리즘이 맞을 것이라고 생각하지만 현실 세계를 다 맞추지는 못한다.
우리 데이터랑 잘 맞으면 쓸모가 있다. 여러개를 비교해 본다.
다른 알고리즘을 사용해서 성능을 비교해 볼 수 있다. 아래와 같이 똑같은 모델을 한번 더 생성한다.
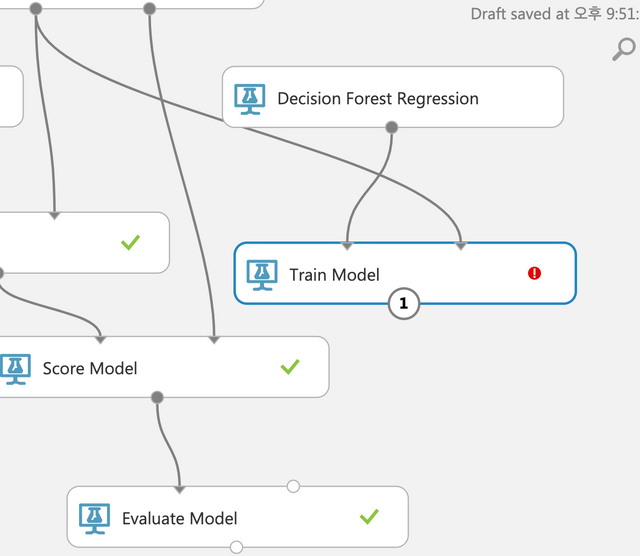
이번에는 Decision Forest Regression을 사용해서 Train Model과 연결한다.
스크린샷 2019-08-21 오후 9.51.04.png
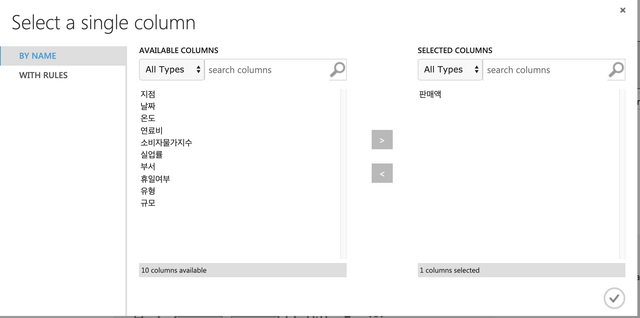
스크린샷 2019-08-21 오후 9.51.27.png
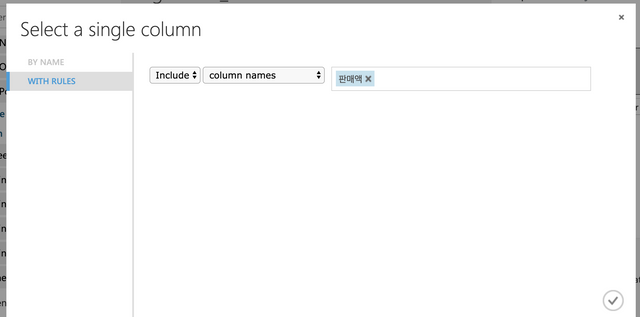
Train Model에서 판매액을 선택한다.
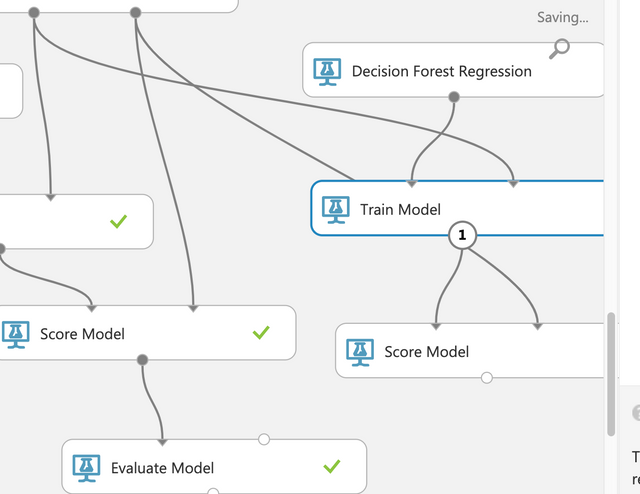
스크린샷 2019-08-21 오후 9.51.53.png
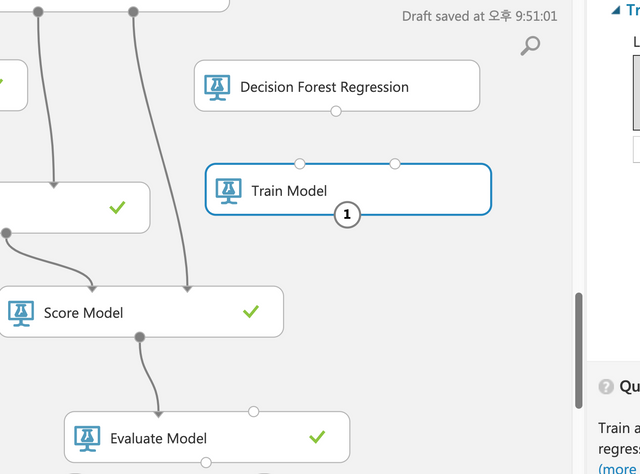
Score Model을 추가해서 아래와 같이 Train Model과 Score Model을 먼저 첫번째 점과 연결한다. Split Data와 두번째 Score Model의 두번째 점으로 연결한다. 두번째 Score Model과 하단의 Evaluate Model을 연결해서 어떤 알고리즘이 더 유리한지 테스트할 수 있다. Run을 누르면 실행시간이 꽤 걸린다. 약 2분에서 5분정도 소요된다.
스크린샷 2019-08-21 오후 9.52.39.png
알고리즘 2개 중에 하나만 남겨둔다. 성능이 좋은 것은 남긴다. 왼쪽을 선택하고 오른쪽은 삭제한다.
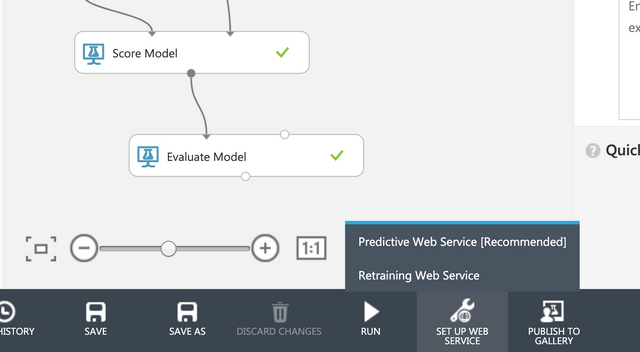
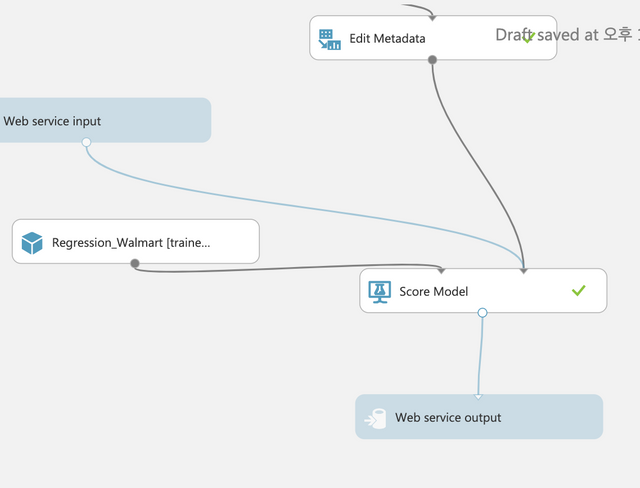
바로 모델을 활용할 수 있는 RESTful 웹사이트가 Azure기반으로 생성된다. 많은 기술들을 사용해야하는데 무척 쉽게 자동으로 생성이 된다.
setup web servervice 리커멘드를 선택한다. 탭이 하나가 더 생긴 것을 볼 수 있다.
스크린샷 2019-08-21 오후 10.00.50.png
Web service input을 아래쪽으로 끌어다 두고 Score model의 상단 두번째 점과 연결한다.
스크린샷 2019-08-21 오후 10.05.16.png
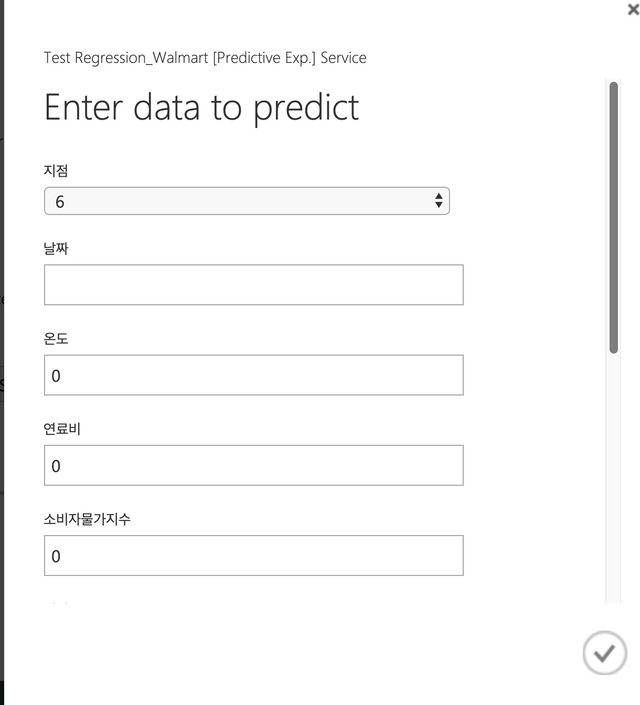
다시 Run버튼을 클릭하고 실행이 종료되었으면 하단의 Deploy Web Service를 클릭하면 된다. Test버튼을 클릭하면 생성된 모델을 사용할 수 있따.
또는 Test preview버튼을 클릭해도 된다.
스크린샷 2019-08-21 오후 10.07.23.png
아래와 같이 샘플 데이터를 바로 로딩해서 테스트 해 볼 수 있다.
윈도우 사용하면서 오피스 2016이면 엑셀로도 다운로드해서 테스트할 수 있다.
판매 금액이 많은 것으로 예측이 되면 직원들을 더 배치할 수 있다. 쿠폰을 주고 판매액을 더 높게 가져갈 수 있다.
마비노기 듀얼에서 Azure ML을 사용하고 있다.
재방문 유도 시스템을 활용하고 있다.
머신러닝이 그렇게 어렵지 않구나 하는 생각
시작점에 도움이 되었으면 좋겠다.

중국 유니트리 회장의 인터뷰 - 중국 유니트리 회장 "이르면 2~3년 내 '로봇 챗GPT' 시대 온다"

2030년정도가 되면 정말 대중화의 시기가 올 것 같습니다. 앞으로 4년이 중요하네요. ㅎㅎ   https://www.youtube.com/watch?v=AoGBLY1hF00